128K 超长上下文
针对超长篇技术白皮书、全库源代码与法律合同提供无损长度注意力,保持跨万行引用的精准语义召回。
DeepSeek官网聚焦大语言模型与超长上下文长推理攻坚。采用创新 MLA 稀疏注意力机制与细粒度专家路由架构,以极低显存成本实现高质量数理逻辑、学术论文长文本推理与全流程代码工程落地。
从底层注意力机制革新到纯强化学习逻辑演进,DeepSeek 构建高通量低时延的工业级通用智能底座。
针对超长篇技术白皮书、全库源代码与法律合同提供无损长度注意力,保持跨万行引用的精准语义召回。
创新压缩 KV Cache 显存开销,在同等硬件集群下并发吞吐提升数倍,兼顾超低首字延迟与长序列生成。
数百亿总参数中每次前向计算仅激活关键专家,计算密度极大化,保障数理学术与工程代码的深度专精。
冷启动强化学习引导自我纠错思维链,面对国际奥数赛题与高难度算法竞技展现严密的跨步验证推理能力。
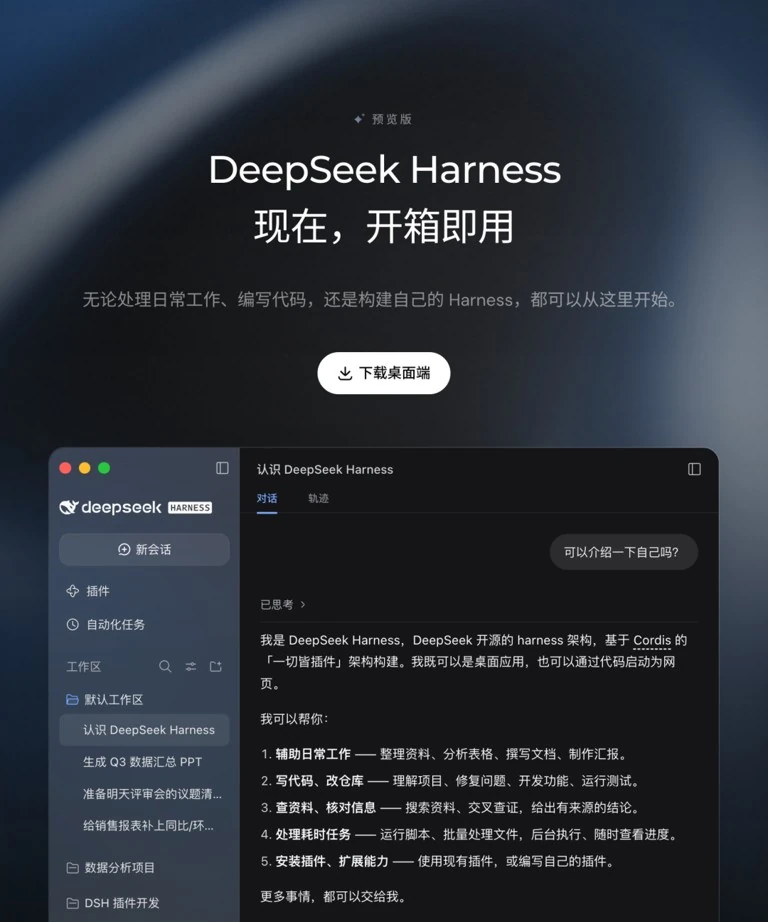
通过 DeepSeek Harness 官方评测框架多维基准检验,呈现算力效率与推理品质的跨代跃升。
| 核心评估维度 | 传统上一代模型 (Baseline) | DeepSeek 最新架构 (V3 / R1) | 架构演进与效能变化 |
|---|---|---|---|
| 上下文长度与无损窗口 | 32K - 64K 上下文,长尾遗忘率升高 | 128K 完整上下文,大海捞针评测 100% 召回 | 有效长度提升 2-4 倍 |
| KV Cache 显存占用 | 标准 MHA 架构,吞吐受显存容量强限制 | 多头潜在注意力 (MLA),动态向量低秩投射 | 显存开销锐减 70%+ |
| 数理推导与思维链 (CoT) | 依赖人工标注 SFT 数据,幻觉难以自我纠正 | 纯强化学习引导自我反思与多重假设回溯 | MATH 基准大幅跃升 |
| 代码工程长任务构建 | 单函数续写尚可,跨多文件仓库推导易断链 | 深度理解全仓依赖,生成生产级高可用单元测试 | HumanEval 通过率领先 |
| API 接入成本与定价 | 百万 Token 价格昂贵,并发限制严格 | 百万 Token 输入仅需几毛钱,普惠开源开放 | 综合调用成本降低 85% |
DeepSeek AI 深度适配科研推理、代码研发、长文本审校及企业级智能体系统。
辅助理论物理学家与数学学者推导复杂偏微分方程、分析张量拓扑结构,利用内置思维链严密验证中间证明步骤。
输入 128K 超长上下文的多模块工程代码,自动分析循环引用、排查并发死锁隐患并生成端到端测试用例。
快速比对上百页上市招股书与监管协议,精准提取责任主体、违约赔偿条款及潜在法律隐患风险点。
通读上千篇 PubMed 生物医药临床论文,自动归纳化合物靶点亲和力、药代动力学参数及实验对照指标。
提供超高指令依从度与精准 JSON/Tool Call 结构化输出,无缝串联各类外部 API 工具及数据库长事务。
支持全权重开源下载,通过 Ollama、vLLM 或 llama.cpp 等开源推理引擎一键搭建企业内部高密闭离线知识库。
满足从移动边缘低功耗运行到云端万亿推理集群的多尺度智能调度需求。
轻量级终端推理模型,适合端侧本地实时问答与基础文本摘要。
专注程序设计与代码长文本分析,精通数十种主流开发语言与框架。
纯强化学习全尺寸深度思考模型,复杂数学、算法竞赛与前沿学术推理首选。
全能型通用大模型,多任务兼顾文学创作、多语言互译与企业级调度。
打破算力高成本壁垒,免去隐藏费用,支持自由按量付费与企业私有化授权。
适合日常数理答疑、长文概括与轻量级对话交互。
兼容 OpenAI 规范接口,弹性并发,按实际消耗精确结算。
针对大中型机构私有内网部署与专项算法微调支持。
标准兼容业界主流调用范式,无缝替换原有 API 请求,直接接入长文本推理底座。
无需重写 SDK 调用逻辑,仅需变更 base_url 与 api_key,即可将现有智能应用一键迁移至 DeepSeek 引擎。
优化底层网络路由,首字生成延迟(TTFT)低至百毫秒级,推理思维链过程平滑逐字反馈。
官方提供自动化基准评测套件,方便科研团队在本地验证精度指标与长上下文检索召回率。
# 请求 DeepSeek-R1 128k 上下文深度推理接口
curl -X POST "help.html#api-endpoint" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-your-deepseek-key" \
  -d '{
    "model": "deepseek-reasoner",
    "messages": [
      {"role": "system", "content": "你是严谨的科学推理助手"},
      {"role": "user", "content": "验证 128K 超长上下文的数理逻辑连贯性"}
    ],
    "stream": false,
    "temperature": 0.6
}'支持 Windows、macOS、Linux、iOS 及 Android 全平台,本地数据加密传输。
独立原生应用具备全局快捷键呼出、剪贴板智能解析及离线代码高亮功能,与网页版会话多端实时云端同步。
以纯粹技术攻坚赢得全球科研界与工业界开发者的高度认可。
听听来自算法工程师、科研学者与开源社区领袖的深度评价。
“在我们将代码重构引擎迁移到 DeepSeek 128k 上下文后,处理万行遗留系统依赖图谱变得异常从容。MLA 架构在长文本吞吐上的表现令人惊叹。”
“DeepSeek-R1 带来的自我反思思维链,在解决高难度数论与图论问题时呈现出惊人的推演条理性,完全刷新了我们对开源推演大模型的认知上限。”
“极具竞争力的 API 定价与开放透明的态度,让独立开发者也能毫无顾虑地构建高频交互 Agent,真正做到了让前沿智能普惠每一个人。”
关于 DeepSeek 官网模型架构、长文本能力与开放平台的关键疑问说明。
持续分享前沿架构探索心得,践行探索未至之境的科学精神。
深入剖析 MLA 如何通过低秩投射压缩隐藏状态维度,并在长文本生成中实现吞吐量飞跃,为更大尺度的上下文长推演奠定物理基石。
阅读全文 →
解密 DeepSeek-R1 如何在极少人工干预下自主学会“顿悟与回溯”,展示大语言模型超越传统模式匹配的自主推理潜力。
阅读全文 →
新增对 128K 超长上下文长推理的多段落连贯性基准测评,提供开箱即用的自动化测试脚本与 Docker 化部署环境。
阅读全文 →无论是通过 DeepSeek 网页版即刻探索 128k 超长上下文,还是通过开放平台构建企业级生产系统,DeepSeek 均为您提供坚实算力基石。